昨天,青小蛙刚刚介绍了 Strata 的更新:Strata 0.2 测试版发布:性能升级,门槛再降低|低配电脑运行本地大模型
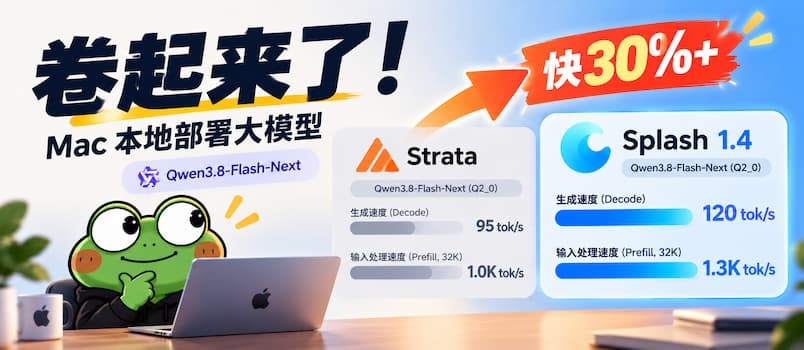
没想到,今天另一款开源本地 AI 推理工具 Splash 就发布了 1.4.0 版本,还直接把 Strata 拉出来比较:
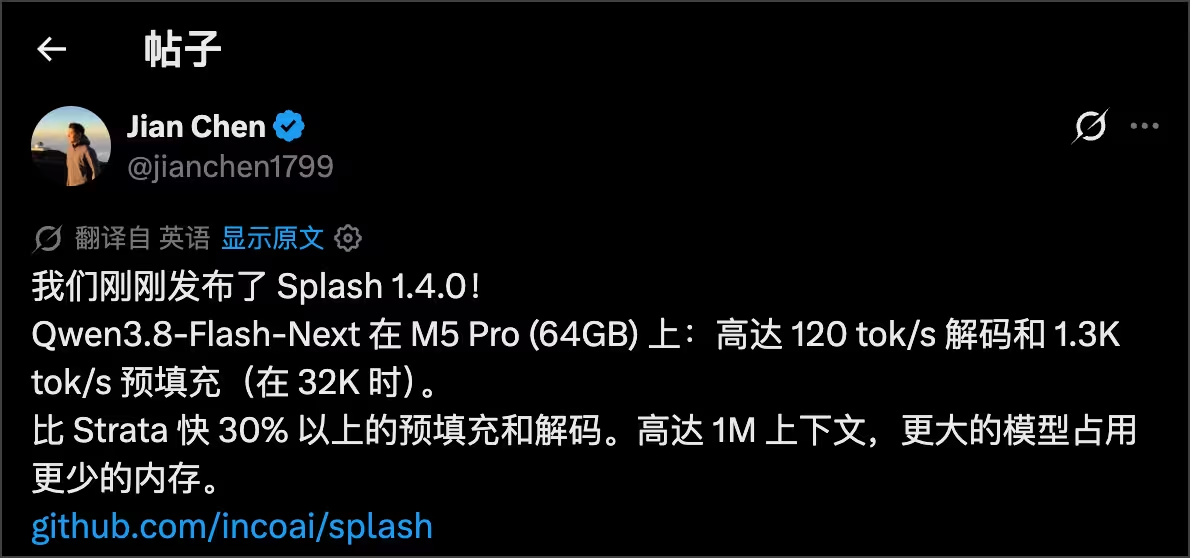
开发者宣布:在相同 Mac、相同模型下,Splash 的输入处理和回答生成速度均比 Strata 快 30% 以上。
真好,本地大模型推理工具也卷起来了。
Splash 1.4 到底有多快?
Splash 是 Inco AI 开发的开源本地 AI 推理引擎,专门针对 Apple Silicon 优化。
这次 Splash 1.4 新增了对 Qwen3.8-Flash-Next 超大模型的支持,开发者使用 M5 Pro、64GB 统一内存的 Mac,运行相同的 Q2_0 量化模型,公布了以下成绩:
| 测试项目 | Splash 1.4 |
|---|---|
| 最高回答生成速度 | 120 tokens/s |
| 短输入生成速度 | 95 tokens/s |
| 32K 输入处理速度 | 1,312 tokens/s |
| 对比 Strata | 约快 30% |
| 最大上下文设置 | 100 万 tokens |
简单理解:
- 回答生成(Decode):就是 AI 一个字一个字往外蹦的速度,越快越流畅。
- 输入处理(Prefill):就是 AI 阅读提示词、长文档和代码的速度,越快越早开始回答。
注意,120 tokens/s 是开发者公布的最高成绩;官方标准测试中的短输入生成速度为 95 tokens/s。100 万上下文也是软件支持的设置上限,并不代表 64GB 的机器可以在这一长度下维持最高速度。
为什么 Splash 能比 Strata 快?
Splash 针对 Apple GPU 优化 Metal 计算内核,以及 DFlash 2 推测解码。它可以让一个小模型提前猜测大模型接下来要生成的内容,再由大模型批量验证,以减少计算次数、提高输出速度。
此外,Splash 还针对不同模型优化内存布局和任务调度,并能复用已经处理过的上下文缓存。
不过,Strata 的 Mac 版本同样使用原生 Metal 引擎,也支持 MTP 推测解码。
因此,这次约 30% 的性能优势,应该看作 Splash 多项优化共同作用的结果。官方尚未公布足够的数据,证明具体是哪项技术贡献最大。
Splash 与 Strata 区别
两者可能不太好直接对比,Strata 同时支持 Windows、Linux 与 macOS,Splash 仅支持 macOS。
但拿出 macOS 进行对比:
| 对比项目 | Splash 1.4 | Strata 0.2.1 |
|---|---|---|
| 最低 Mac 芯片 | M3 | M1 |
| 最低 macOS 版本 | 26.4 | 15 |
| 内存门槛 | 24GB 可尝试较小模型 | 官方总体建议 32GB 起 |
| 大模型内存不足 | 自动内存规划及缓存优化 | SSD 流式加载专家参数 |
| 上下文上限 | 最高 100 万 tokens | 模型支持至 262K,官方主要验证到 32K |
| 平台支持 | 仅 Apple Silicon Mac | Windows、Linux、Mac |
先看下限:Strata 更宽松。
Strata 的 Mac 版本从 M1 起支持 Mac,即使模型无法全部装进内存,也能通过 SSD 流式加载部分参数。
开发者甚至在一台 M1 Max、34GB 内存的 Mac 上,以约 7.9 tokens/s 的速度运行 Qwen3.8-Flash-Next Q2_0。
Splash 则要求至少 M3 芯片和 macOS 26.4。24GB 内存的 Mac 可以选择较小的 GGUF 模型。
再看上限:Splash 在同等硬件上的速度表现更突出
Splash 在 M5 Pro、64GB 内存上跑出了很高的生成速度,官方同机测试比 Strata 快约 30%。
它还支持最长 100 万 tokens 的上下文设置,适合有长文档、代码库处理需求的用户。不过,实际能达到的长度仍受模型和可用内存限制。
Strata 则提供了更广泛的硬件适应能力,包括在内存不足时继续运行超大模型。至于两者谁能运行更大的模型,目前缺乏相同硬件条件下的完整测试,暂时还不能下结论。
简单来说:
Strata 更照顾旧设备和低配置;Splash 则更专注于让新款 Mac 发挥性能。
这里有一张 scomper 同学的测试图片:
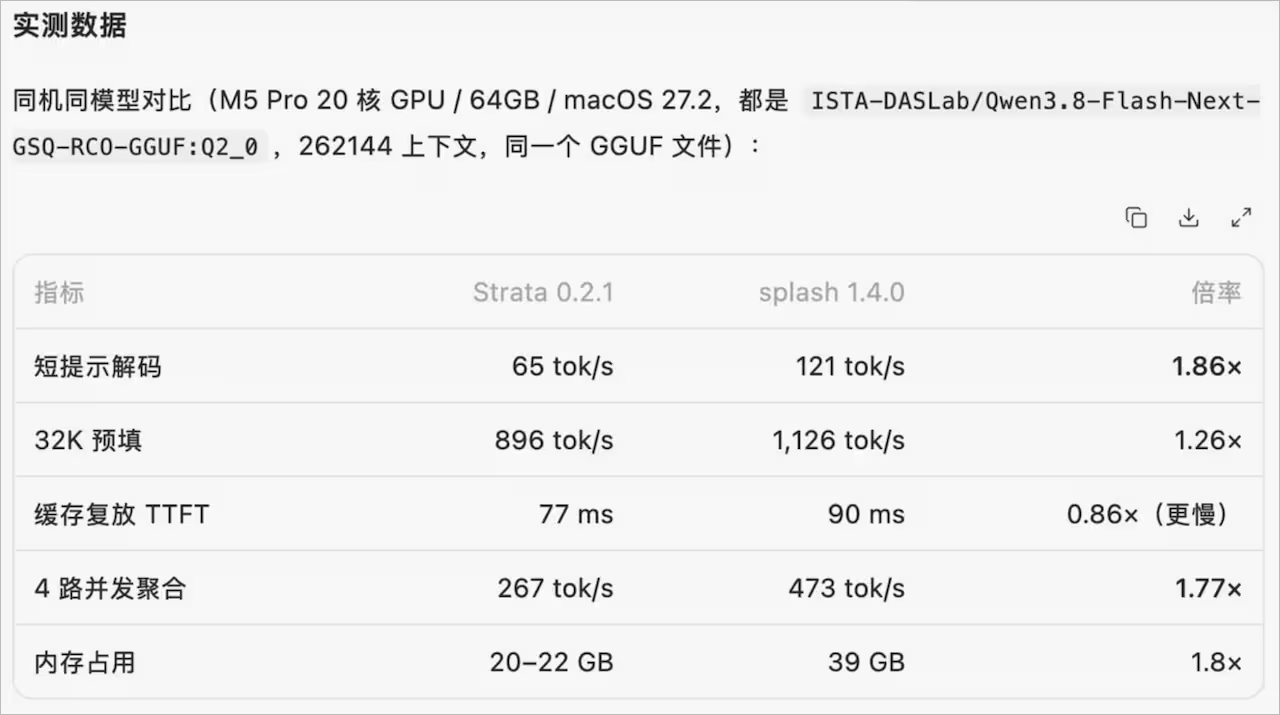
Splash 如何安装?
对于拥有 M3 以上 Mac 设备的用户,推荐选择 Splash,老设备用户则使用 Strata 就好。
安装命令:
brew install incoai/tap/splash
运行 Qwen3.8-Flash-Next:
splash serve --model ISTA-DASLab/Qwen3.8-Flash-Next-GSQ-RCO-GGUF:Q2_0
首次启动需要下载模型和配套的辅助文件,请预留充足的磁盘空间。
除了内置聊天页面,Splash 还兼容 OpenAI 和 Anthropic API,支持连接 Claude Code、Codex、OpenCode 等 AI 编程工具。
另外,Splash 免费开源,采用 Apache 2.0 许可证。
最后
昨天 Strata 刚升级,今天 Splash 就拿出了更快的测试成绩。
两者都在解决一个问题:如何让普通电脑更快的运行本地超大模型。
卷起来吧,继续降低硬件门槛,继续压榨硬件性能!
原文:https://www.appinn.com/splash-1-4/