Strata · 追踪报道(共 10 篇)
- Strata 0.2.18 新增 220B 开源大模型 Hy4-Flash,门槛上涨至 64GB 内存 (当前文章)
- Strata 0.2.10 发布:本地 AI 大模型继续提速,默认使用 DFlash2 降低显存需求,8GB 显卡也能开启 128K 上下文
- Strata 0.2.9 发布:本地大模型 Prefill 最高提速 88%,还支持 1 比特 DeepSeek
- Strata 0.2.8 发布:取消默认开启的 12GB 及以下显存加速功能,RTX 3060 生成代码快了 37%|支持 NVIDIA DGX Spark
- Strata 0.2.4 更新:12GB 显卡运行 DeepSeek V4.1-Flash
- Strata 0.2.3 更新:聊天太长?现在会自动压缩了
- Strata 0.2.2 发布:新增多显卡自由分工,Gyro 推理提速最高 30%
- Strata 0.2 测试版发布:性能升级,门槛再降低|低配电脑运行本地大模型
- Strata 现已支持 macOS,还能运行更轻量的 Qwen3.6-35B-A3B 大模型了
- 8GB显存就够,Strata 让普通电脑也能运行千亿参数大模型
- Strata 0.2.18 新增 220B 开源大模型 Hy4-Flash,门槛上涨至 64GB 内存 (当前文章)
- Strata 0.2.10 发布:本地 AI 大模型继续提速,默认使用 DFlash2 降低显存需求,8GB 显卡也能开启 128K 上下文
本地大模型运行工具 Strata 更新到了 0.2.18,新增了对腾讯混元 Hy4-Flash 的原生支持。不过,入门内存已经增加至 64GB。@Appinn
Strata 是一个可以让普通家用电脑也能比较快速的运行开源大模型的工具,主要支持 Qwen3.8-Fl1sh-Next、Qwen3.6-35B-A3B,也支持 1 比特 DeepSeek。
Hy4-Flash 是一款总参数 224B、每个 Token 激活约 12B 参数的 MoE 大模型。支持图像理解和最高 100 万 Token 的上下文。
Strata 为它准备了专用推理引擎、三档量化和内置推测解码。
那么问题来了:
- Hy4-Flash 比 Qwen3.8-Flash-Next 强吗?
- 如果你的电脑已经能跑 Qwen3.8-Flash-Next,还能换成 Hy4-Flash 吗?
Strata 0.2.18 更新了什么?
Strata 0.2.18 于北京时间 11 月 22 日发布,桌面版与命令行版本均升级到 0.2.18,推理引擎和负责安装更新的 Control 升级到 0.1.64。
主要更新:
- 原生支持 Hy4-Flash。新增独立的
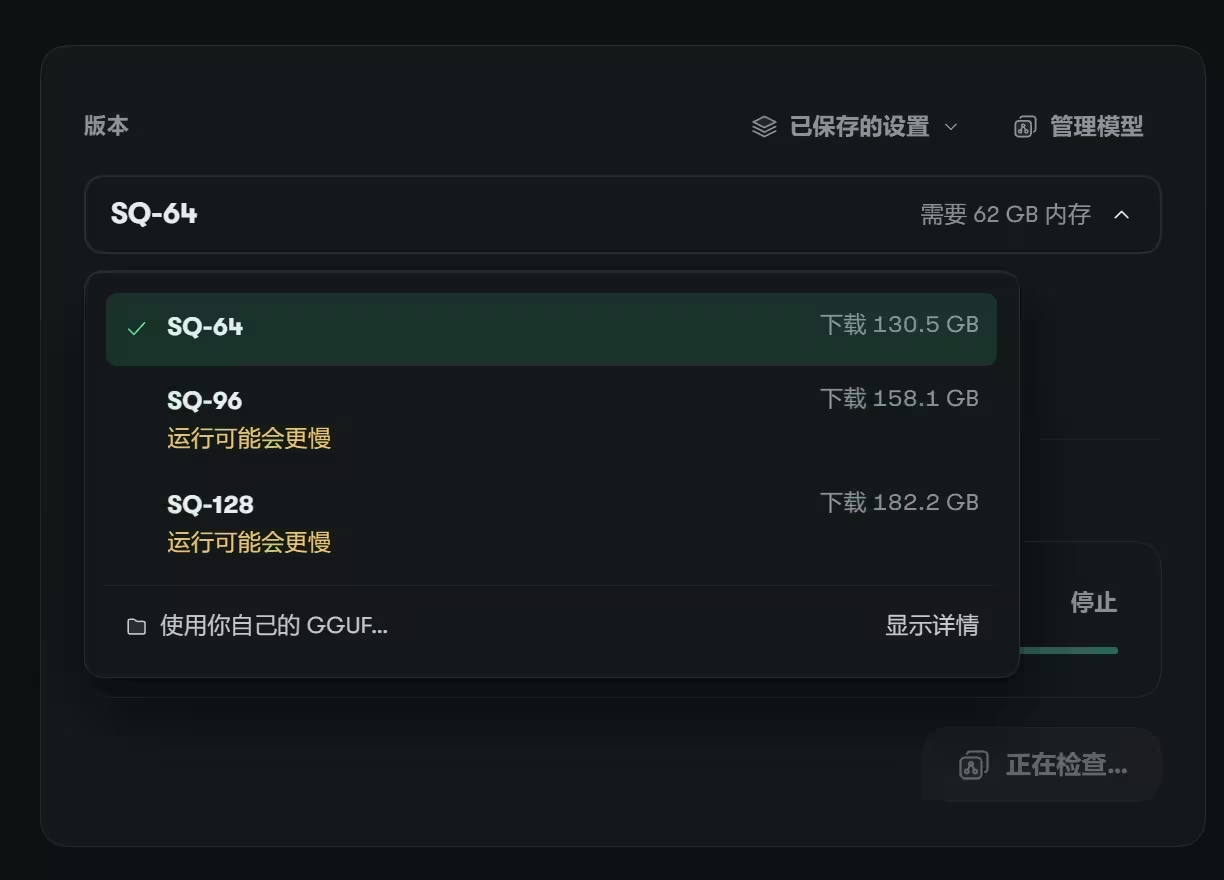
strata-hy4推理引擎,选择 Hy4-Flash 量化包时会按需下载。 - 三档量化。SQ-64、SQ-96、SQ-128 分别面向不同的内存配置。
- 内置 DFly2 推测解码,用于加快生成。桌面版与
strata launch都支持。 - 图像理解。可加载单独的 Vision 组件,文件大小为 0.93 GB。
- 跨平台运行。支持 Windows、Linux、搭载 Apple 芯片的 Mac 以及 DGX Spark。可用的显卡后端因系统而异。
升级后,原有的 Qwen、DeepSeek 模型以及聊天记录和设置都会保留。
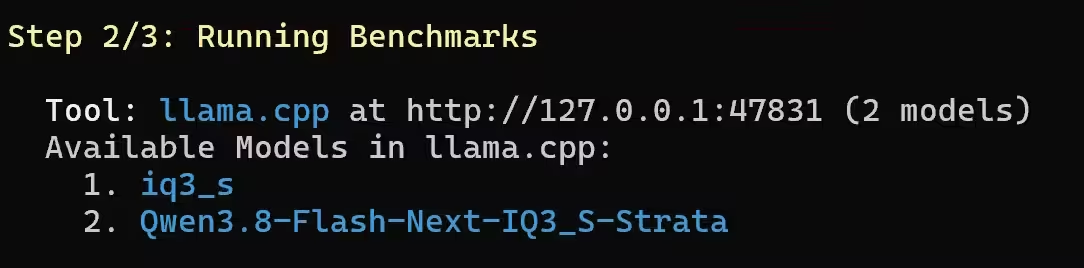
另外,现在的 API 可以使用原始模型名称了:
Hy4-Flash 与 Qwen3.8-Flash-Next 有什么区别?
两款模型都采用 MoE(混合专家)架构。模型拥有大量参数,每次生成一个 Token 时只调用其中一部分参与计算。Hy4-Flash 的总参数含约 64B Engram 查找参数,每个 Token 激活约 12B 参数。
Hy4-Flash 支持百万级上下文,腾讯将它用于 Agent、文档处理和电脑操作。Qwen3.8-Flash-Next 在 Strata 里已有多种适合消费级硬件的低比特量化方案。
谁的实际能力更强?
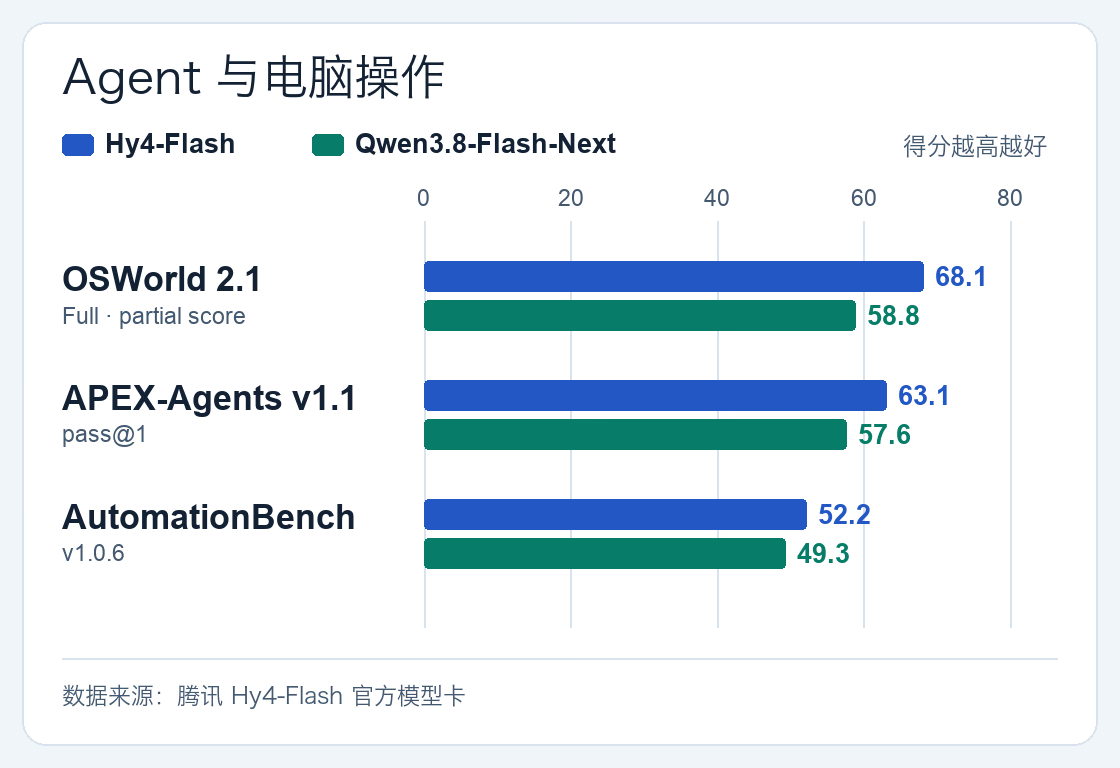
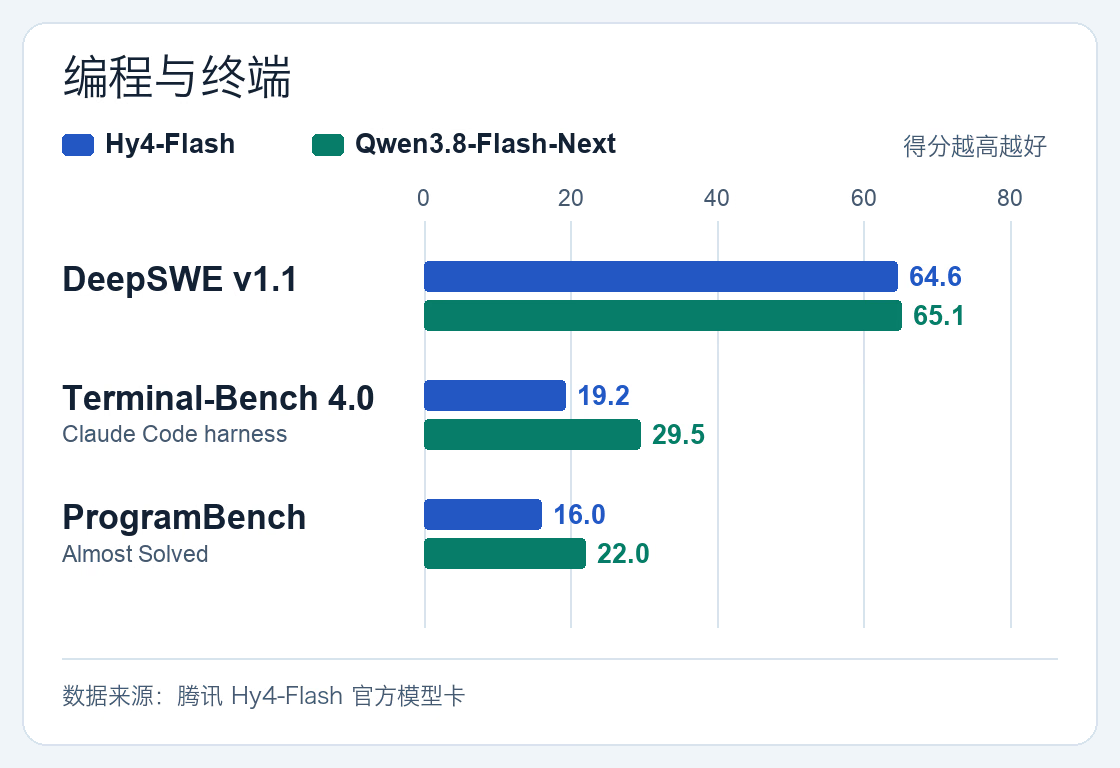
以下对比数据来自腾讯 Hy4-Flash 官方模型卡附录的评测结果,分数越高越好。腾讯对每款模型采用各自可用的最高推理档位。
Agent 与电脑操作
在选取的三项 Agent 测试里,Hy4-Flash 得分都更高。以衡量图形界面操作的 OSWorld 2.1 为例,完整测试集的部分得分(partial score)是 68.1 对 58.8,相差 9.3 分。
编程与终端
这三项测试里,Qwen3.8-Flash-Next 得分更高。两者在 DeepSWE v1.1 上只差 0.5 分,差距最大的是使用 Claude Code 测试框架的 Terminal-Bench 4.0,Qwen 得分 29.5,Hy4-Flash 为 19.2。
门槛以升,本地运行需要多少内存?
Strata 为 Hy4-Flash 提供三档量化。以下是官方更新日志列出的磁盘占用和目标内存配置。
| 量化 | 磁盘占用 | 官方内存配置 |
|---|---|---|
| SQ-64 | 129.61 GB | 64 GiB 起 |
| SQ-96 | 157.16 GB | 面向 96 GiB 系统 |
| SQ-128 | 181.23 GB | 128 GiB 起 |
官方列出的 SQ-64 起步配置是 64 GiB 系统内存,搭配 8、12 或 16 GiB 显存。即便手里有一张 24GB 显存的 RTX 3090,48GB 系统内存也低于这一档的官方起步要求。
也就是说,运行 Hy4-Flash 至少需要 64GB 内存才可以,青小蛙表示已经无力测试了。
已经在用 Strata,需要升级吗?
内存足够的情况下,当然升级啊 😂
下图是青小蛙最近一段时间以来,使用 RTX3090 + 48GB 内存,运行 Qwen-Flash-Next IQ3_S 的测速情况,基于 llm-bench:
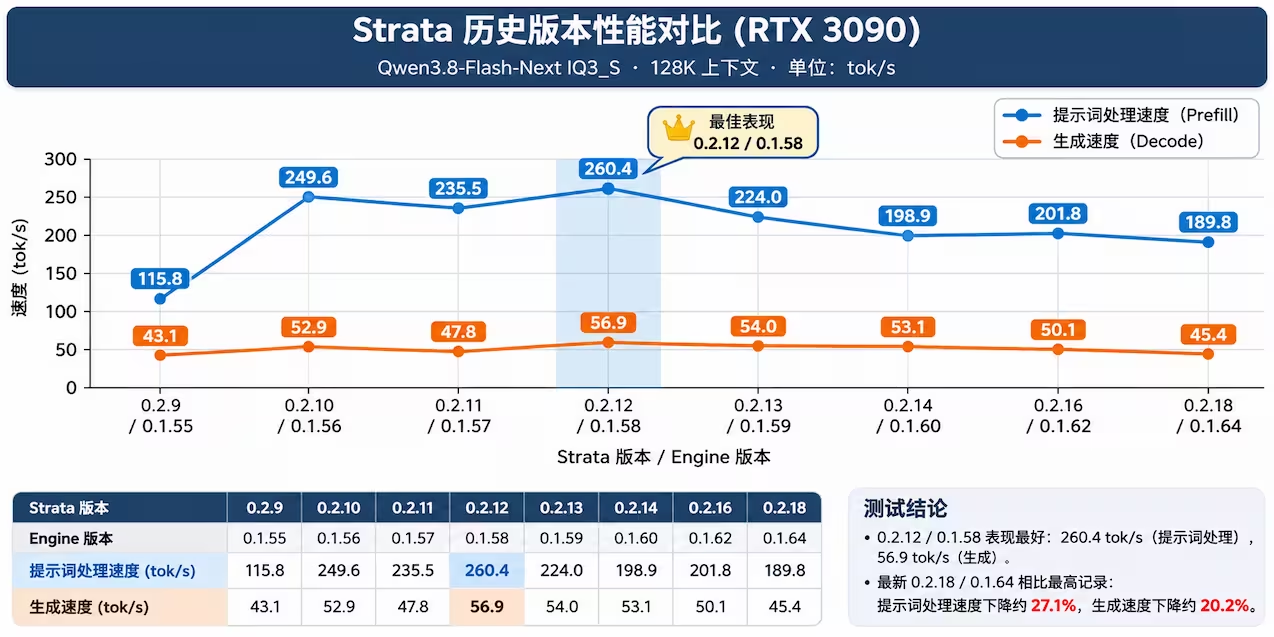
仅代表此电脑,建议都可以测试一下,我的 llm-bench 命令行:
C:\llm-benchmark.exe benchmark --endpoint http://127.0.0.1:47831 --tool Strata --tool-key KEYKEY
对于小于 64GB 内存的配置,现阶段继续用 Qwen 更实际。如果已经有 96 GiB 或 128 GiB 内存,可以按自己的任务试试 Hy4-Flash。
获取
原文:https://www.appinn.com/strata-0-2-18/