Strata · 追踪报道(共 5 篇)
- Strata 0.2.3 更新:聊天太长?现在会自动压缩了 (当前文章)
- Strata 0.2.2 发布:新增多显卡自由分工,Gyro 推理提速最高 30%
Strata 是什么?
Strata 是一款免费开源的本地大模型运行工具,支持 Windows、macOS 和 Linux,能够让普通电脑运行大型 AI 模型,最低只需要 8GB 显存。
昨天刚刚更新多显卡支持的本地大模型推理工具 Strata 0.2.2,今天又发布了 0.2.3 正式版,引擎也同步更新 0.1.48 版本。一天一个版本,未来青小蛙决定不跟这么紧了,跟不住 😂
这次主要提升推理性能、改善 AI Agent 长对话体验,并正式提供 Intel Arc 显卡的 Linux 推理引擎。
推理速度提升,最高 45%
这次更新带来了两组值得关注的性能数据:
- AMD Strix Halo(Ryzen AI Max):相比 0.2.2,回答速度提升 6%~19%,其中代码生成提升 18%、工具调用提升 19%。
- NVIDIA RTX 5070 12GB:优化 CPU 线程和显存分配后,Gyro-S 模型生成速度从 31 提升至 45 tokens/s,约提升 45%(对比基准为 0.2.1)。
不过,这些数据来自特定硬件和模型,其他显卡的提升幅度仍需实测。
AI Agent 长对话更稳定
此前,本地 AI Agent 在连续执行任务时,容易因为聊天记录越来越长而耗尽上下文(长对话极其消耗内存,本地电脑会因为内存耗尽而导致 Strata 直接崩溃)。
现在 Strata 可以自动检查上下文占用、分段总结旧消息,并在超出限制时提供「总结并继续」选项。
此外,还新增了 /compact 命令,可以主动压缩对话历史。
新增 DFlash2 推测解码
Strata 还加入了实验性的 DFlash2 推测解码,尝试通过草稿模型提前预测 token,提高生成速度。
目前需要在终端手动开启:
strata launch --drafting dflash2
不过官方表示,DFlash2 尚未在所有硬件场景中证明优于默认的 MTP,因此暂时没有默认启用。
其他更新
- Intel Arc:正式提供 Linux SYCL 推理引擎安装包。
- macOS:修复较长提示词导致 Metal 引擎中止的问题。
- 终端:改善重复启动、服务重启和 API Key 保留机制。
- 内存缓存:根据剩余内存自动分配对话缓存,提高多 Agent 场景下的提示词复用效率。
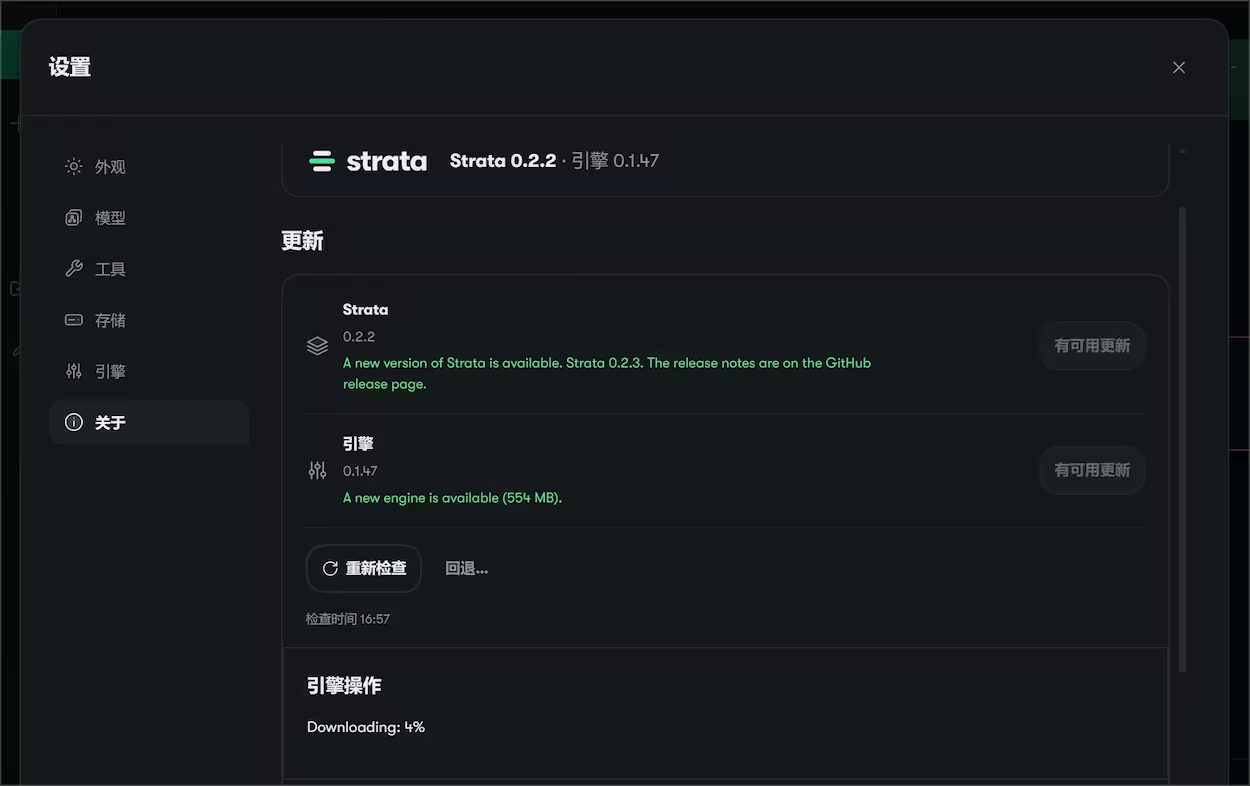
已经安装 0.2.2 的用户,可以通过设置页面更新。
注意在桌面版本的关于页面升级,引擎那个部分可能会出现 0.1.0 版本,尝试重启,应该就好了。